وقتی صحبت از هوش مصنوعی می شود، ظاهر می تواند فریبنده باشد. رمز و راز پیرامون عملکرد درونی مدلهای زبانی بزرگ (LLM) از اندازه عظیم، روشهای آموزشی پیچیده، رفتار پیشبینینشده سخت، و تفسیرپذیری گریزان آنها ناشی میشود.
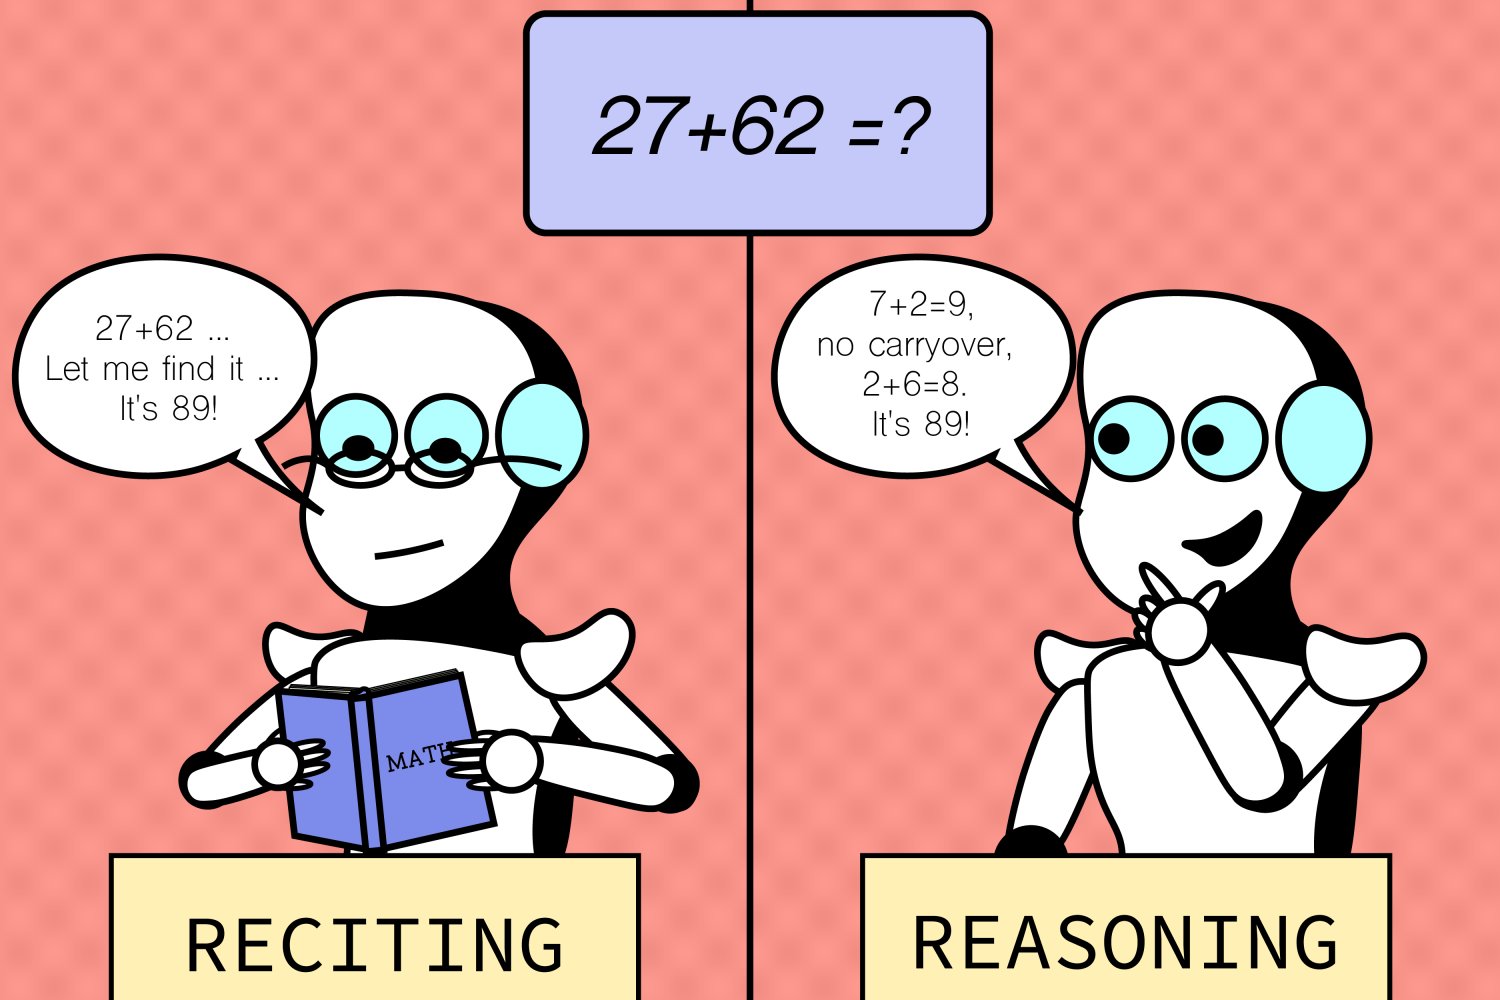
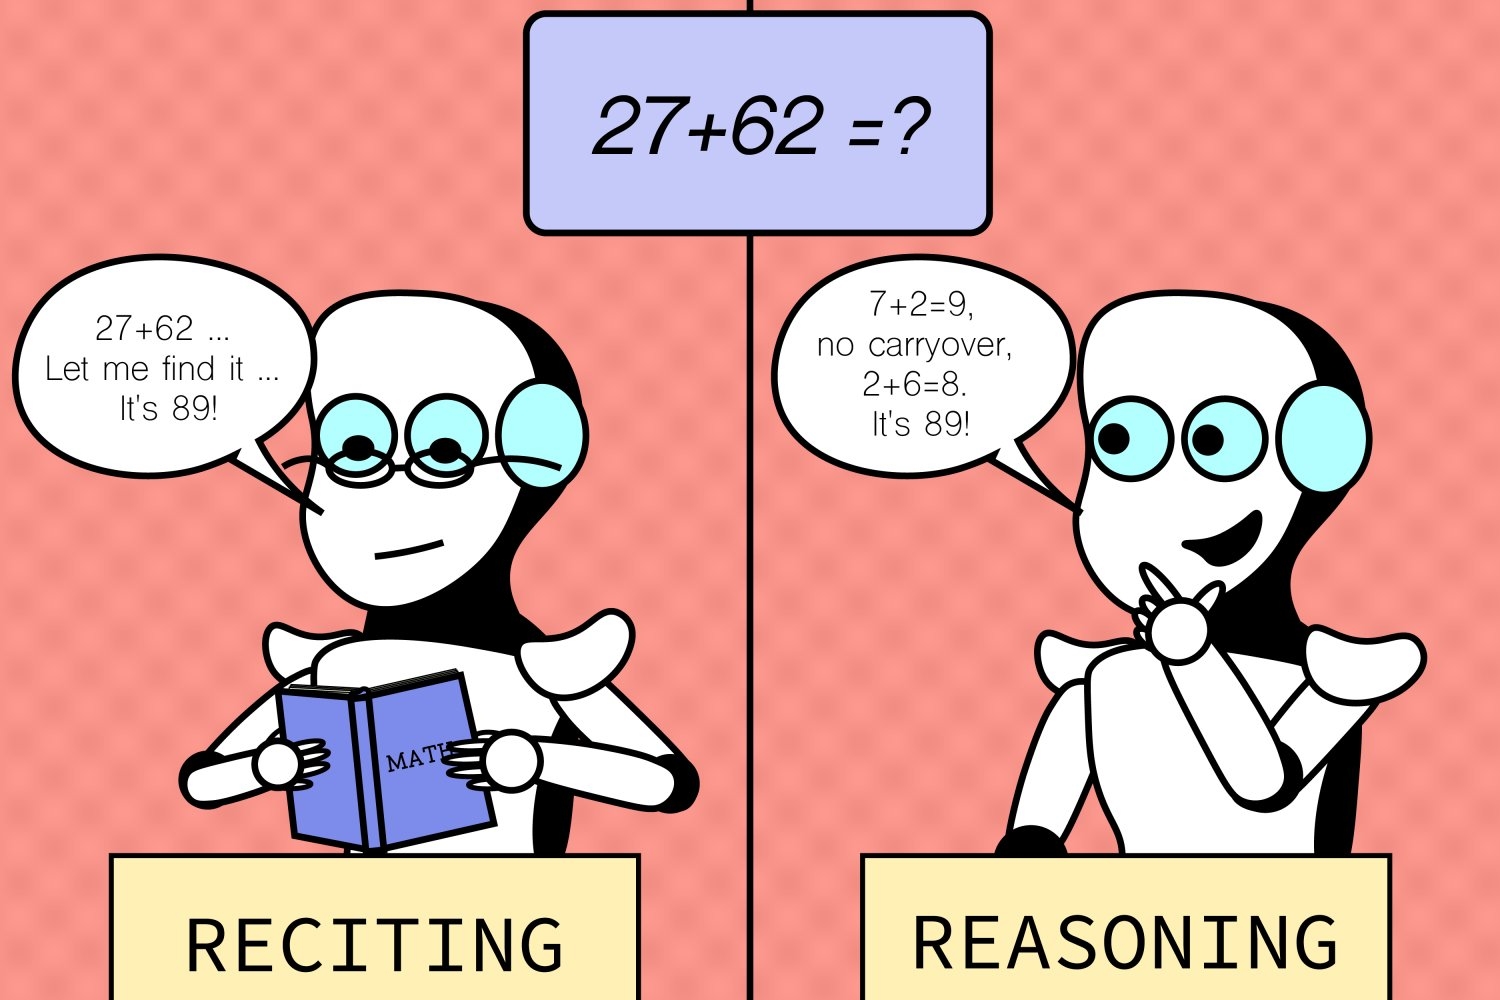
محققان آزمایشگاه علوم کامپیوتر و هوش مصنوعی MIT (CSAIL) اخیراً زیر ذره بین ضرب المثل را بررسی کردند تا چگونگی کنار آمدن LLM ها با تغییرات در وظایف مختلف را بررسی کنند و بینش های جالبی را در مورد تعامل بین مهارت های به خاطر سپردن و استدلال آشکار کردند. معلوم می شود که توانایی های استدلال آنها اغلب بیش از حد ارزیابی می شود.
این مطالعه «وظایف پیشفرض»، وظایف رایجی را که مدل بر روی آنها آموزش و آزمایش شده بود، با «سناریوهای خلاف واقع»، موقعیتهای فرضی انحراف از شرایط پیشفرض مقایسه کرد – که معمولاً از مدلهایی مانند GPT-4 و کلود انتظار میرود که از عهده آن برآیند. محققان برخی از آزمایشها را در خارج از مناطق راحتی مدلها با اصلاح وظایف موجود به جای ایجاد وظایف کاملاً جدید توسعه دادند. آنها از مجموعه داده ها و معیارهای مختلفی استفاده کردند که به طور خاص برای جنبه های مختلف قابلیت های مدل ها برای مواردی مانند حساب، شطرنج، ارزیابی کد، پاسخ به سؤالات منطقی و غیره طراحی شده بودند.
هنگامی که کاربران با مدلهای زبان تعامل دارند، هر حسابی معمولاً در پایه 10 است، پایه اعداد آشنا برای مدلها. اما مشاهده اینکه آنها در پایه 10 خوب عمل می کنند، می تواند این تصور اشتباه را به ما بدهد که آنها شایستگی بالایی نیز دارند. منطقاً، اگر آنها واقعاً مهارتهای جمعآوری خوبی داشتند، انتظار عملکرد قابلاعتماد بالایی در همه پایههای اعداد، درست مانند ماشینحسابها یا رایانهها دارید. در واقع، تحقیقات نشان داده است که این الگوها آنقدر قوی نیستند که در ابتدا تصور می شد. عملکرد بالای آنها محدود به انواع کارهای رایج است و آنها از کاهش مداوم و شدید عملکرد در سناریوهای تطبیق ناآشنا رنج می برند که نشان دهنده فقدان توانایی تعمیم است.
این الگو برای بسیاری از کارهای دیگر مانند نواختن آکوردهای موسیقی، استدلال فضایی، و حتی کارهای شطرنج که در آن موقعیت شروع مهره ها کمی تغییر می کند، صادق است. اگرچه انتظار میرود بازیکنان انسانی همچنان بتوانند قانونی بودن حرکات را در سناریوهای تغییر یافته تعیین کنند (با توجه به زمان کافی)، مدلها با مشکل مواجه شدند و نتوانستند بهتر از حدس زدن تصادفی عمل کنند، به این معنی که توانایی محدودی برای تعمیم به موقعیتهای ناآشنا دارند. و بسیاری از عملکرد آنها در وظایف استاندارد احتمالاً به دلیل توانایی های کلی کار نیست، بلکه به دلیل تنظیم مجدد یا یادآوری مستقیم از آنچه در داده های آموزشی خود دیده اند است.
ما یک جنبه جذاب از مدلهای زبان بزرگ را کشف کردیم: آنها در سناریوهای آشنا، تقریباً مانند یک مسیر پیمودهشده، برتری میکنند، اما زمانی که زمین ناآشنا میشود، دچار مشکل میشوند. ژائوفنگ وو، دانشجوی دکترای مهندسی برق و علوم کامپیوتر در MIT، وابسته به CSAIL و نویسنده اصلی یک مقاله جدید، میگوید: این بینش بسیار مهم است زیرا ما به دنبال بهبود سازگاری این مدلها و گسترش افق کاربرد آنها هستیم. کاغذ در مورد تحقیق «از آنجایی که هوش مصنوعی در جامعه ما فراگیرتر می شود، باید سناریوهای مختلف را به طور قابل اعتماد مدیریت کند، خواه آشنا باشند یا نه. ما امیدواریم که این بینش ها روزی به طراحی LLM های آینده با پایداری بهتر کمک کند.
با وجود بینش های به دست آمده، البته محدودیت هایی وجود دارد. تمرکز این مطالعه بر وظایف و تنظیمات خاص، طیف کاملی از چالشهایی را که مدلها میتوانند به طور بالقوه در برنامههای کاربردی دنیای واقعی با آن مواجه شوند، نشان نمیدهد و نیاز به محیطهای آزمایشی متنوعتر را نشان میدهد. کار آینده می تواند شامل گسترش مجموعه وظایف و شرایط مقایسه برای آشکار کردن نقاط ضعف بالقوه بیشتر باشد. این ممکن است به معنای در نظر گرفتن سناریوهای پیچیده تر و کمتر رایج باشد. این تیم همچنین میخواهد با ایجاد روشهایی برای درک بهتر منطق پشت فرآیندهای تصمیمگیری مدلها، قابلیت تفسیر را بهبود بخشد.
هائو پنگ، استادیار دانشگاه ایلینویز در Urbana-Champaign میگوید: «با افزایش مقیاس مدلهای زبان، درک دادههای آموزشی آنها حتی برای مدلهای باز، چه رسد به مدلهای اختصاصی، چالشبرانگیزتر میشود. «جامعه در اینکه آیا این مدلها واقعاً به کارهای نادیده تعمیم میدهند یا به نظر میرسد با به خاطر سپردن دادههای آموزشی موفق میشوند، متحیر مانده است. این مقاله گام های مهمی در پرداختن به این موضوع برداشته است. مجموعهای از معیارهای با دقت طراحی شده را ایجاد میکند و بینش جدیدی در مورد قابلیتهای پیشرفتهترین LLM ارائه میکند. این نشان می دهد که توانایی آنها برای حل کارهای نامرئی شاید بسیار محدودتر از آن چیزی است که بسیاری انتظار دارند. این پتانسیل الهام بخش تحقیقات آینده برای شناسایی حالت های شکست مدل های امروزی و توسعه مدل های بهتر است.
نویسندگان دیگر عبارتند از ناجونگ کیم، که استادیار دانشگاه بوستون و محقق بازدیدکننده گوگل است، و هفت شرکت وابسته به CSAIL: دانشجویان دکتری مهندسی برق و علوم کامپیوتر MIT (EECS)، لینلو کیو، الکسیس راس، اکین آکیورک SM ’21، و بویوان. چن؛ پسادکتر و محقق سابق هوش مصنوعی اپل بایلین وانگ؛ و استادیاران EECS Jacob Andreas و Yoon Kim.
تحقیقات این تیم تا حدی توسط آزمایشگاه هوش مصنوعی MIT–IBM Watson، MIT Quest for Intelligence و بنیاد ملی علوم پشتیبانی شد. این تیم ماه گذشته کار خود را در انجمن زبانشناسی محاسباتی آمریکای شمالی (NAACL) ارائه کرد.